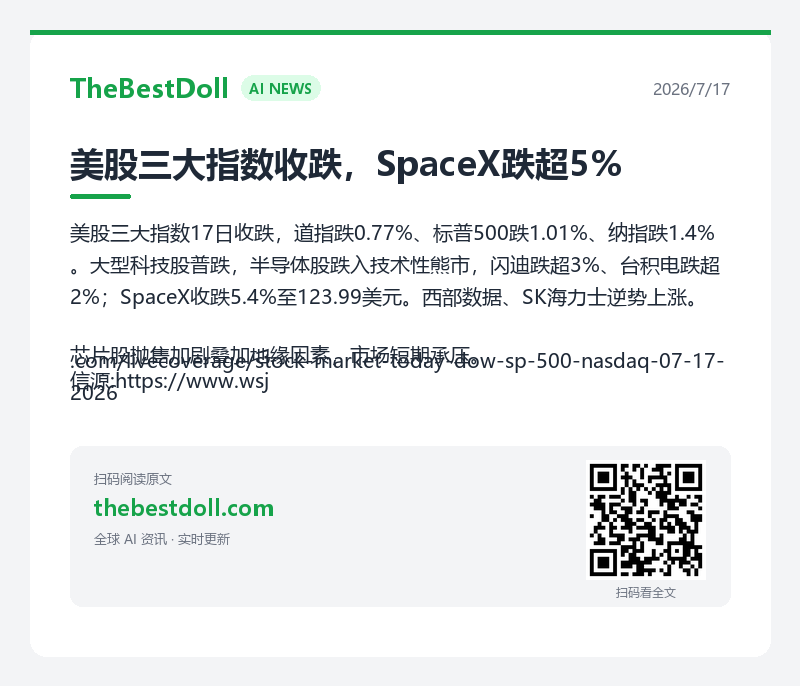
7月17日,NVIDIA发布博客,强调Vera Rubin平台通过端到端协同设计,在代理AI(agentic AI)的持续后训练阶段最大化“智能每美元”。文章指出,代理模型需不断从生产环境反馈中强化学习,后训练已从一次性步骤变为永续循环,成本每代token直接决定模型迭代速度与经济可行性。Blackwell已降低单次运行成本,Vera Rubin进一步将最大模型训练GPU数量减至四分之一,并与Vera CPU结合实现30%更高吞吐。
这一动作正值代理AI从demo迈向真实运营的关键窗口。OpenAI、Anthropic等模型公司正大力推广企业代理,而后训练的算力需求呈指数级增长——Prime Intellect、Perplexity、Together AI等伙伴已在Blackwell上运行强化学习循环,Vera Rubin被定位为下一代基础设施。相比之下,AMD等竞争者仍在追赶CUDA生态,超大规模云厂商自研芯片虽降低依赖,但短期内难以匹敌NVIDIA全栈(NeMo RL、Dynamo等工具)的成熟度。
数据层面,Nemotron 3 Ultra在SWE-bench verified上达到71.7%,证明后训练配方已能规模化产出可用智能。30% CPU吞吐提升与权重秒级同步能力,直接转化为更频繁的rollout循环,让“智能每美元”成为新的KPI,而非单纯的训练FLOPS。
短期看,NVIDIA借此巩固代理时代基础设施主导权;长期则面临自研芯片与主权算力工厂的分散挑战。未来6-12个月,若Vera Rubin实际部署数据持续领先,行业资本将进一步向效率而非单纯规模倾斜;反之,模型公司可能加速转向混合架构。
**信源**:
https://blogs.nvidia.com/blog/nvidia-vera-rubin-post-training-intelligence-per-dollar/ (2026-07-17)
https://techstartups.com/2026/07/17/top-tech-news-today-july-17-2026-anthropic-apple-google-meta-moonshot-ai-nvidia-more/ (2026-07-17)
📱 分享到微信
或长按图片 → Save to Photos → 发到微信
📤 分享这篇文章
点击”分享微信好友”→ 长按图片发到微信